


El ITA presenta en el Foro Europeo de Big Data Value 2026 cómo el aprendizaje federado puede mejorar los modelos de IA en el sector vitivinícola
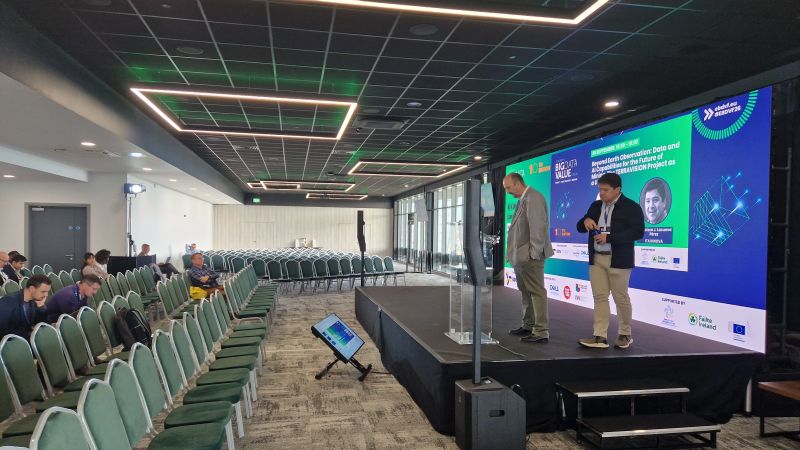
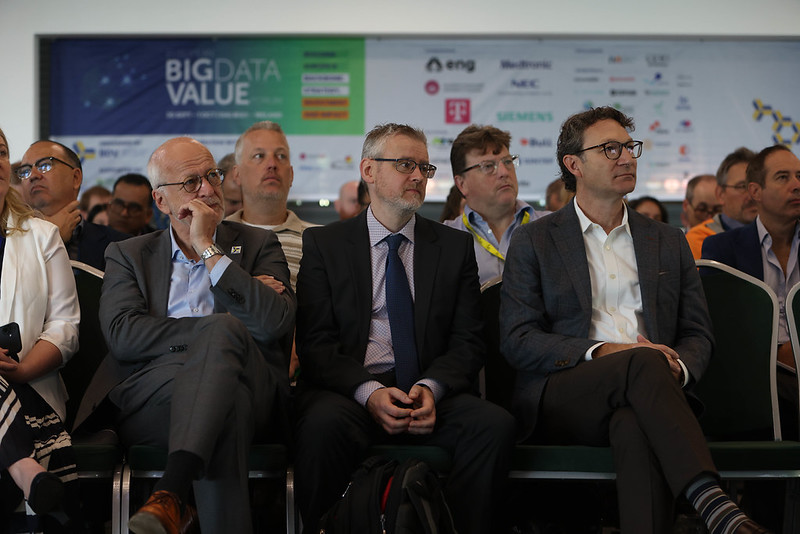
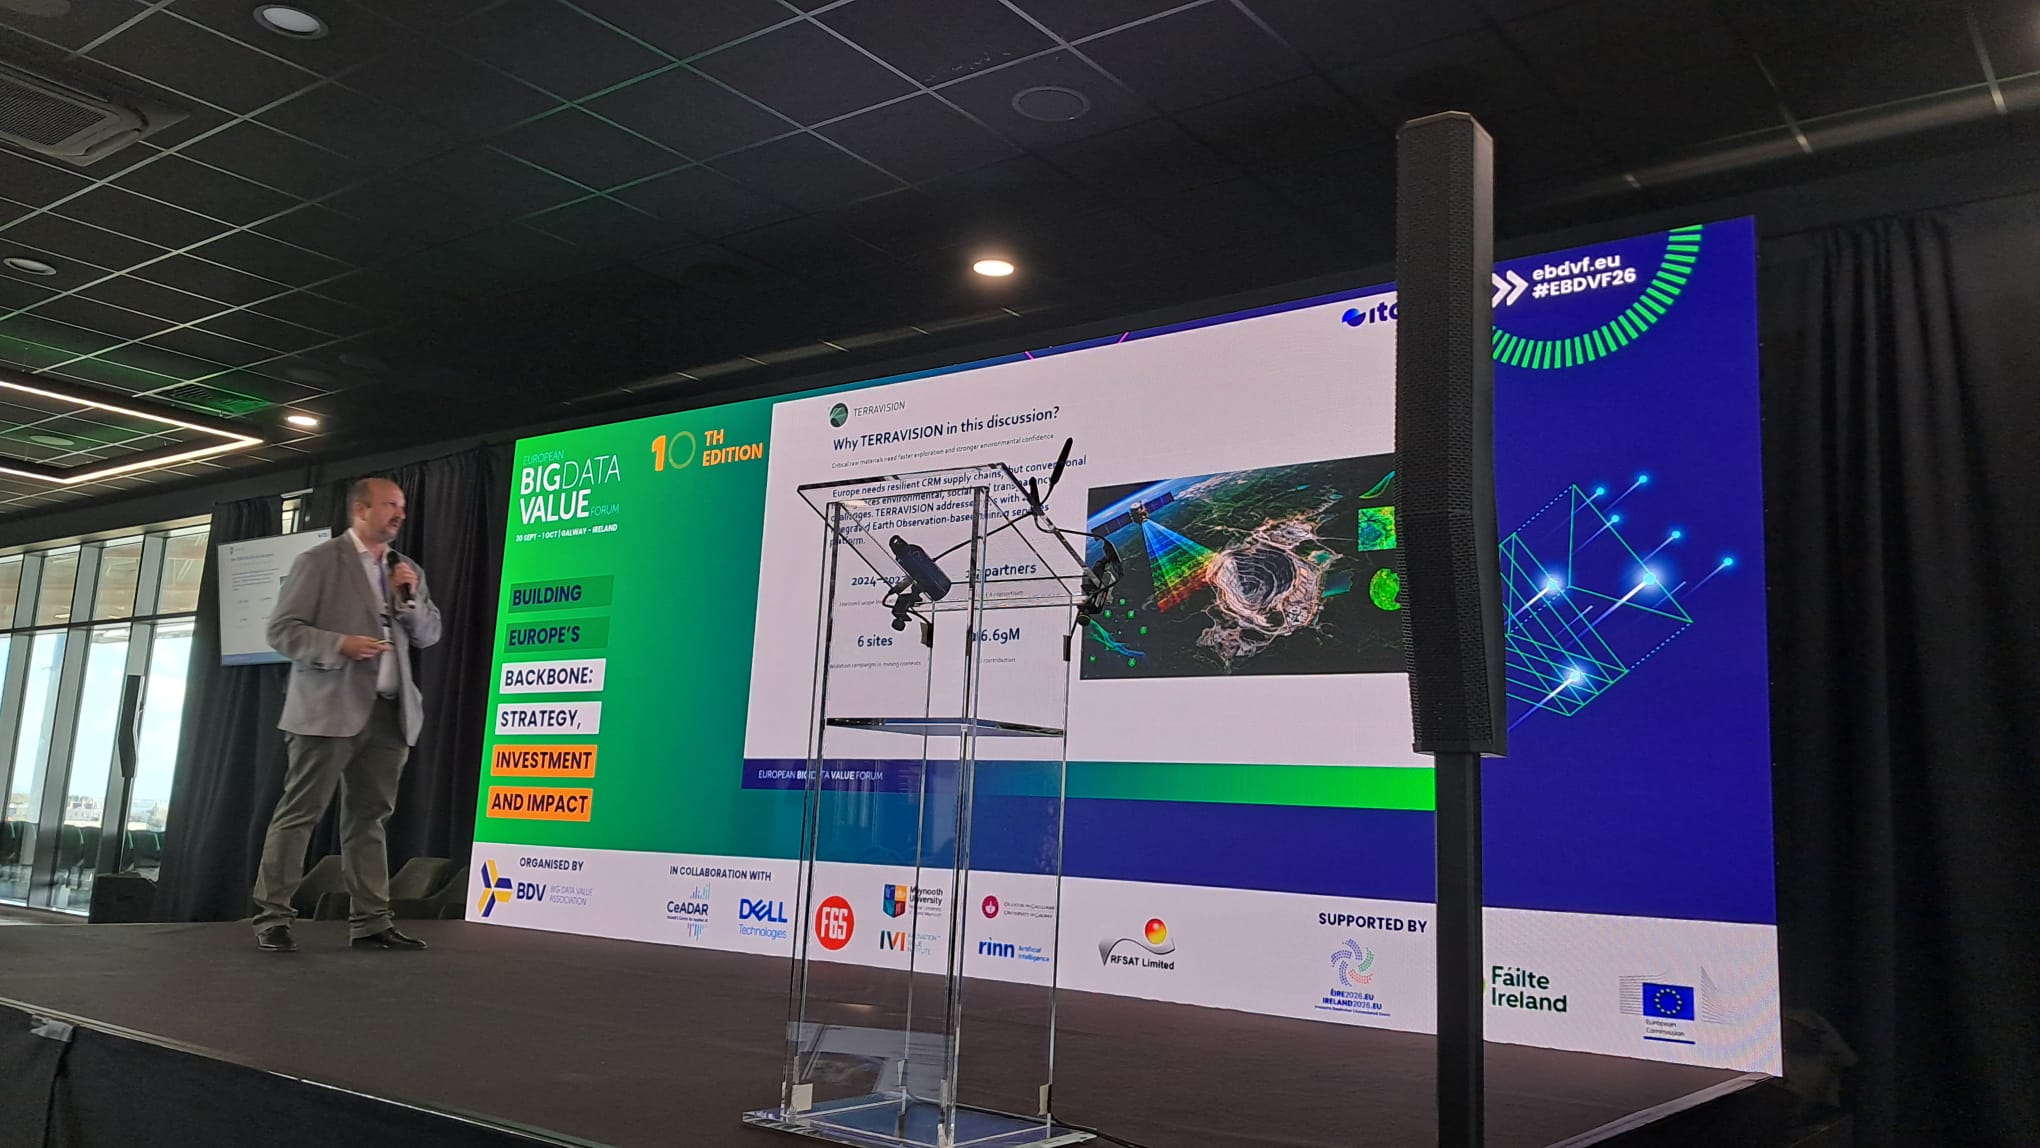
Rafael del Hoyo y Francisco J. Lacueva, del equipo de Big Data y Sistemas Cognitivos del ITA, asistieron al 10º Foro Europeo de Big Data Value (EBDVF) 2026. El evento se celebró del 30 de septiembre al 1 de octubre en el Dexcom Stadium de Galway, Irlanda, y forma parte de los actos oficiales de la Presidencia irlandesa de la UE, con el apoyo de la Comisión Europea y de Fáilte Ireland. Esta edición reunió a las comunidades europeas de datos, inteligencia artificial e investigación bajo el lema «Construir la columna vertebral europea de la IA y los datos: estrategia, inversión e impacto».
Durante el foro, el ITA presentó varios proyectos europeos en los que participa. Entre ellos, TITAN-EOSC.
Compartir datos sin perder el control
Uno de los principales obstáculos en el desarrollo de modelos de Machine Learning es la dificultad de compartir datos entre actores que compiten en un mismo sector. Los data spaces facilitan un intercambio seguro de información entre organizaciones, pero se centran en preservar la soberanía y la confidencialidad de los datos de cada participante. Esto es esencial para generar confianza, aunque puede limitar la disponibilidad de conjuntos de datos amplios y diversos, y con ello la capacidad de entrenar modelos representativos de distintos escenarios operacionales.
TITAN-EOSC aborda este reto desde dos enfoques complementarios. Por un lado, desarrolla funcionalidades sobre el data space de EOSC que refuerzan la protección de los datos mediante cifrado y anonimización avanzados. Así es posible compartirlos sin revelar su origen ni comprometer información sensible de las organizaciones participantes.
Por otro lado, el proyecto impulsa plataformas de aprendizaje federado, en las que los datos permanecen en las infraestructuras de cada entidad. En este modelo, los modelos base y el código de entrenamiento se desplazan a cada nodo, donde se reentrenan localmente. El conocimiento adquirido se integra después en un modelo global mediante la agregación de los parámetros aprendidos, sin centralizar ni exponer los datos originales.
Un caso de uso en el sector vitivinícola
La adopción de estas aproximaciones es especialmente relevante en el sector vitivinícola, que se enfrenta a la reducción del consumo y a la necesidad de mejorar su competitividad y sostenibilidad. TITAN-EOSC emplea datos de las Denominaciones de Origen Protegidas Cariñena, Campo de Borja y Calatayud, así como de la explotación Vaporrichela, en la región italiana del Véneto. Con ellos evalúa y compara modelos de IA para predecir la fenología de la vid y el riesgo de desarrollo de oídio.
El objetivo es analizar las diferencias entre los modelos entrenados de forma centralizada, agregando los datos en una única infraestructura, y los desarrollados con algoritmos e infraestructuras de aprendizaje federado, en los que los datos siguen bajo el control de sus propietarios.
En este caso de uso participan la Región del Véneto, SARGA y el Instituto Tecnológico de Aragón (ITA), en colaboración con la Universidad de Murcia. Su trabajo contribuye a demostrar cómo las tecnologías de compartición segura de datos y el aprendizaje federado permiten crear modelos más robustos y representativos sin comprometer la soberanía de los datos de los actores implicados.

ITA - Instituto Tecnológico de Aragón
ARTÍCULOS DEL MÍSMO ÁMBITO
-

ITA | Viernes, 09 Octubre 2026
-
OTROS ARTÍCULOS
-
-
ITA | Viernes, 16 Octubre 2026

